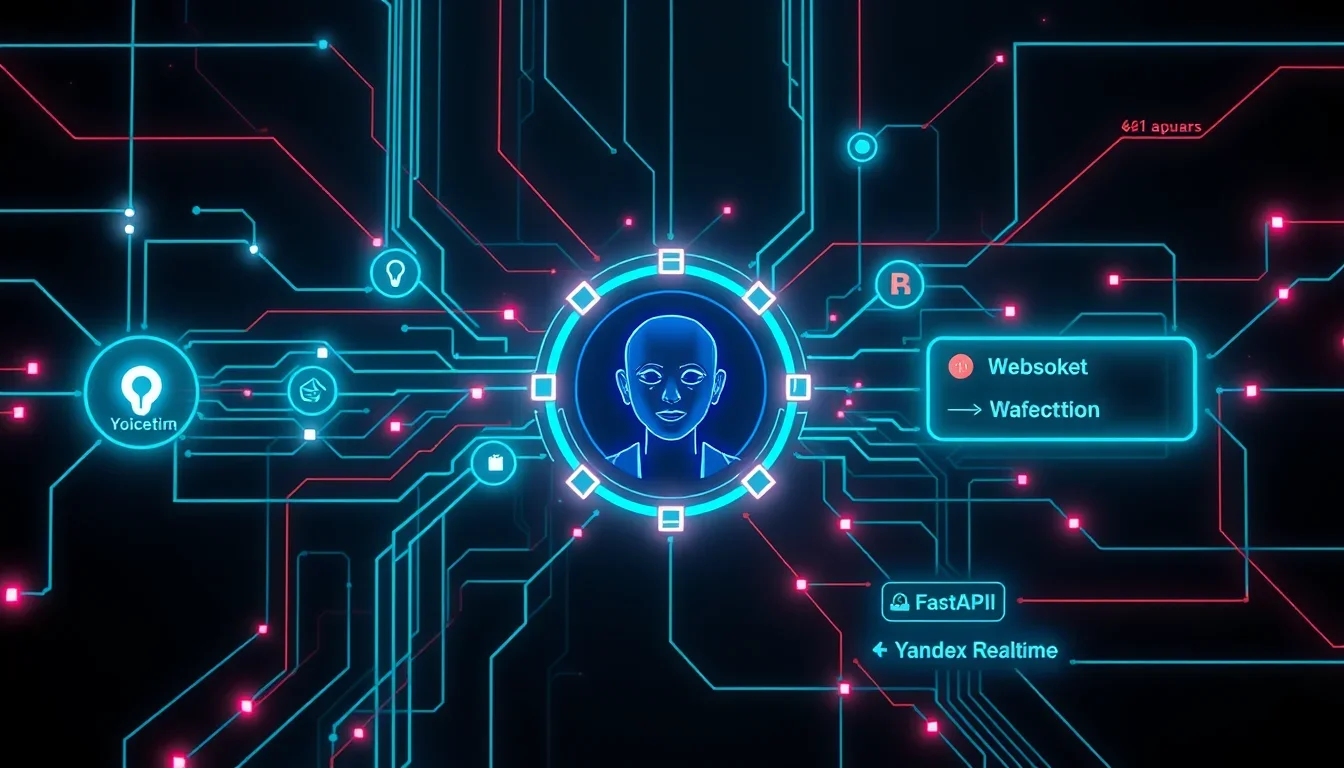
إن دمج الصورة الرمزية للذكاء الاصطناعي في مساعد الصوت الحالي آيكا ليس مجرد إضافة وجه، بل هو سلسلة كاملة من التحديات التقنية. لقد سعينا للحفاظ على البنية الحالية على Yandex Realtime، بحيث يقوم الخدمة الجديدة فقط بتحريك الشفاه للصوت الذي تم إنشاؤه بالفعل. أثناء اختبار Simli و Anam، ظهرت فروق دقيقة تتعلق بالتوقفات قبل الرد، وتشغيل الفيديو على iPhone، واستقرار الإنترنت عبر الهاتف المحمول. وعند إنشاء الشخصية الثانية، إيفا، أصبح من الواضح أن إقناع الشبكة العصبية لا يعتمد فقط على الوجه نفسه، بل على السياق أيضًا.
كان محركنا الصوتي يعمل بالفعل، لذا كانت المهمة تقتصر على تحريك الوجه فقط. تتواصل آيكا مع زوار الموقع مباشرة في المتصفح عبر WebSocket، المتصل بخادمنا على FastAPI، والذي بدوره يحافظ على جلسة مع Yandex Realtime. وهذا يضمن وضع “الكلام إلى كلام”، مما يلغي الحاجة إلى سلاسل منفصلة للتعرف، ونموذج نصي، وتوليف.
يقوم الخادم بنقل الصوت غير المضغوط إلى المتصفح بتنسيق PCM16 بتردد 24 كيلو هرتز على أجزاء (pcm_chunk)، وكان من الضروري مزامنة تعابير الصورة الرمزية مع هذا التدفق.
اختيار منصة الصورة الرمزية للذكاء الاصطناعي: Simli مقابل Anam
تقدم كلتا الخدمتين المختبرتين – Simli و Anam – وضعًا يوفر فيه المستخدم تدفقه الصوتي، وتقوم الخدمة بإنشاء فيديو بوجه متحرك، متزامن مع الصوت، وإرجاع الوسائط عبر WebRTC. وبالتالي، يستمر Yandex في إنشاء الكلام، وتتولى خدمة الصورة الرمزية المسؤولية عن المكون المرئي.
الجوانب الفنية لدمج الصوت
- معدل أخذ العينات: يصدر Yandex الصوت بتردد 24 كيلو هرتز. يتطلب Simli 16 كيلو هرتز، وتم ضبط Anam أيضًا على 16 كيلو هرتز، على الرغم من أنه يدعم تنسيقات أخرى.
- معالجة أجزاء الصوت: يصل الصوت على أجزاء. لتجنب التشوهات عند الوصلات، يتم نقل الموضع الكسري والعينة الأخيرة إلى الجزء التالي. وهذا يضمن سلاسة الرسوم المتحركة، على الرغم من أن جودة إعادة حساب التردد بدون مرشح كامل لا تزال تتطلب تحسينًا.
الأمان وإدارة الجلسات
لا يصل مفتاح الخدمة إلى المتصفح. تطلب الصفحة من خادمنا رمز جلسة قصير الأجل عبر POST /voice/avatar-session. يتحقق الخادم من origin ويحد من إصدار الرموز: 6 في الساعة لكل IP و 30 في الساعة إجمالاً.
إذا لم يتم الحصول على الرمز أو لم يتم تشغيل الفيديو، تنتقل الصفحة إلى وضع الصوت العادي. يتم تخصيص 8 ثوانٍ لطلب الرمز، و 15 ثانية لتشغيل SDK. من المهم أن التشغيل الناجح لـ SDK لا يضمن الظهور الفوري للإطار الأول؛ الوجه هنا هو إضافة، وليس وظيفة حرجة.
إدارة حالة الأفاتار في Anam
يوفر Anam أمرين رئيسيين:
endSequence(): يتم استدعاؤه بعد إرسال آخر جزء صوتي من الكلام.interruptPersona(): يوقف الكلام الحالي للأفاتار عند المقاطعة، وبعد ذلك يتم استدعاءendSequence()أيضًا.
مقارنة Simli (الجيل القديم) و Anam Cara-4
لقد قمنا بمقارنة الإصدارات المتاحة لنا: Simli من الجيل السابق و Anam Cara-4. هذه ليست مقارنة شاملة لجميع الميزات، بل اختيار لمهمة محددة.
| المعلمة | Simli (الجيل السابق) | Anam Cara-4 |
|---|---|---|
| تعبيرات الوجه | تتحرك الشفاه، وتعبيرات الوجه الأخرى محدودة | يرمش، يبتسم، تظهر الأسنان، يميل الرأس |
| إنشاء الوجه | من صورة عبر واجهة برمجة التطبيقات للجيل السابق | من صورة واحدة، يتوفر فيديو تجريبي |
بشكل شخصي، أظهر Anam تعبيرات وجه أكثر حيوية وطبيعية. بالنسبة لنا، كان هذا هو العامل الحاسم. بعد ذلك، واجهنا عددًا من المشاكل المحددة.
ميزات تشغيل الوسائط
- الصوت: في Simli، كان الصوت يُشغل عبر عنصر صوتي منفصل، بينما في Anam، يتم تشغيله عبر نفس عنصر الفيديو. هذا يعني أنه لا يمكن ترك عنصر فيديو Anam
muted، وإلا سيتحدث الأفاتار بصمت. - الدقة: غالبًا ما يبدأ الفيديو بدقة منخفضة (384×576) ولا يتحول إلى دقة عالية (768×1152) إلا بعد بضع ثوانٍ. كان خيار
sessionOptions.videoQuality: "high"يساعد، لكنه لا يضمن البدء بجودة عالية. - تأخير توليد الإطارات: يتطلب Anam استقبال 0.8 ثانية من الصوت قبل البدء في توليد الإطارات. هذا لا يساوي دائمًا 0.8 ثانية من الانتظار في الوقت الفعلي، حيث يمكن أن يصل الصوت بشكل أسرع مما يتم تشغيله.
إدارة الميكروفون والجلسات
- قمع الصدى: على الهاتف، بينما تتحدث آيكا، يتم إيقاف تشغيل الميكروفون لتجنب التقاط صوتها من مكبر الصوت. على الكمبيوتر الشخصي، يكون الميكروفون نشطًا، وعندما يبدأ المستخدم في التحدث (حدث
barge_inمن Yandex Realtime)، يوقف الأفاتار كلامه الحالي. - خانة الجلسة المشغولة: في الخطة المجانية، تتوفر جلسة واحدة متزامنة. في حالة تعطل المتصفح، قد تظل الخانة مشغولة. يساعد طلب
GET /v1/sessions/concurrencyفي تشخيص انشغال الخانات. - إلغاء الاتصال: إذا نقر المستخدم على “إيقاف” أثناء اتصال الفيديو، فمن الضروري إنهاء العمليات غير المتزامنة بشكل صحيح لتجنب ترك جلسة غير ضرورية. لهذا الغرض، تم إدخال عداد أجيال
videoGen.
مشاكل مع Safari على iPhone
على iPhone في Safari، لم يتم تشغيل الفيديو. ترتبط الفرضية بقواعد التشغيل التلقائي. ساعد الاستدعاء الأولي لـ play() على عنصر الفيديو مع توفير مؤقت للتدفق من canvas وإزالة muted في التشغيل التجريبي، لكنه ليس حلاً عالميًا.
تحسين فترة التوقف قبل الرد
فترة التوقف الطويلة قبل رد الأفاتار، الذي ينظر بصمت إلى المستخدم، تبدو أثقل بكثير مما لو لم تكن موجودة. في البداية، تم تعيين عتبة الصمت (VAD) على 2.2 ثانية حتى لا تقاطع آيكا المستخدمين الذين يملون المعلومات مع فترات توقف.
لقد نقلنا منطق جسر الهاتف إلى الموقع: في المحادثة العادية، العتبة هي 1500 مللي ثانية، وعند الإملاء تكون 2200 مللي ثانية. هذا يسمح بتعديل حساسية VAD ديناميكيًا. يتم تطبيق الإعدادات عبر session.update دون إعادة الاتصال.
إنشاء شخصية ثانية: إيفا
بالنسبة لمديرة الاستوديو إيفا، واجهنا مشكلة “الشخصية الشقراء الجاهزة” على خلفية فارغة. جاءت نقطة التحول عندما ظهرت خلفية داخلية: مصابيح دافئة، أرفف، نباتات، وخلفية بعيدة ضبابية. هذا جعل الصورة أكثر إقناعًا، محولًا “الكتالوج” إلى “شخص في مكان عمله”.
تفاصيل إنشاء الخلفية والصورة الشخصية
- الخلفية: استخدمنا تصميمًا داخليًا جاهزًا بأسلوبنا، مع إزالة الأشخاص باستخدام المولد.
- قص الشخصية: تم قص إيفا باستخدام أدوات macOS Vision (
VNGeneratePersonSegmentationRequestبمستوى.accurate). تم تضييق حافة القناع وتنعيمها لإزالة الهالة. - المقياس: من المهم الحفاظ على مقياس العناصر في الخلفية لتجنب المواقف الكوميدية (على سبيل المثال، كوب عملاق خلف الظهر). تم أخذ الخلفية فقط فوق سطح الطاولة وتم تمويهها لعدسة التصوير الشخصي.
- الدقة: بالنسبة لـ Cara-4، يوصى بمصدر مربع بحجم 1152×1152. التكبير النظيف Real-ESRGAN ×4 جعل البشرة ناعمة جدًا. بدا مزيج التكبير العصبي مع التكبير العادي، وزيادة الحدة، وإضافة الحبيبات أفضل.
التعليق الصوتي لإيفا
بالنسبة لإيفا، تم اختيار صوت من عائلة LiveTTS من Yandex. في SpeechKit API v3، يتم اختيار النموذج عبر "model": "livetts"، ويتم تمرير الصوت والدور عبر hints. بالنسبة للنصوص الطويلة، تم تقسيم النص إلى جمل وتم توليفه بشكل منفصل.
من بين سبعة خيارات للتعليق الصوتي لجملة واحدة، تم اختيار صوت vera في دور casual. كان لا بد من إعادة كتابة الجملة، حيث كان التوليف يخطئ باستمرار في النبرة.
تسجيل مقاطع الفيديو مع الأفاتار
تم تسجيل فيديو إيفا عبر نفس محرك الرسوم المتحركة المستخدم للمكالمات الحية، باستخدام MediaRecorder مباشرة من video.srcObject (الفيديو والصوت معًا، WebM مع VP9 و Opus). لبدء التسجيل بشكل صحيح، تم “إيقاظ” البث مسبقًا بثانية من الصمت حتى لا يبدأ الفيديو بشاشة سوداء.
الأسئلة المتكررة
ما هو الأفاتار المدعوم بالذكاء الاصطناعي وكيف يعمل؟
الأفاتار المدعوم بالذكاء الاصطناعي هو شخصية رقمية قادرة على تحريك تعابير الوجه وحركات الشفاه وفقًا للصوت المقدم. يستخدم الشبكات العصبية لإنشاء صورة بصرية واقعية تتزامن مع الكلام، مما يجعل التفاعل أكثر طبيعية وجاذبية.
هل يمكنني استخدام صوتي الخاص لـ AI-avatar؟
نعم، تسمح معظم المنصات، مثل Anam و Simli، باستخدام محرك الصوت الخاص بك أو الصوت المسجل مسبقًا. سيقوم الصورة الرمزية بتحريك الوجه وفقًا لتدفق الصوت هذا، مما يحافظ على هوية علامتك التجارية أو شخصيتك.
ما هي الصعوبات الرئيسية عند دمج AI-avatar؟
من بين الصعوبات الرئيسية مزامنة الصوت والفيديو، ومعالجة مقاطع الصوت، وتحسين التأخيرات، وضمان التشغيل المستقر على الأجهزة المختلفة (خاصة الأجهزة المحمولة)، بالإضافة إلى إنشاء صورة بصرية مقنعة تتوافق مع السياق والعلامة التجارية.
كيف يؤثر الخلفية على إدراك AI-avatar؟
تلعب الخلفية دورًا حاسمًا في إنشاء صورة مقنعة. يمكن أن تجعل الخلفية الفارغة أو غير المناسبة الصورة الرمزية تبدو غير طبيعية. يزيد التصميم الداخلي الذي يتوافق مع أسلوب الشخصية أو العلامة التجارية بشكل كبير من الواقعية والثقة في الصورة الرمزية، مما يخلق شعورًا بوجود «شخص في مكان العمل».
كم تكلفة إنشاء AI-avatar؟
يمكن أن تختلف تكلفة إنشاء AI-avatar بشكل كبير اعتمادًا على المنصة المختارة، ومستوى التخصيص، وتفاصيل تعابير الوجه، والحاجة إلى وظائف فريدة. تقدم بعض الخدمات نماذج اشتراك، بينما قد تفرض أخرى رسومًا على كل دقيقة من الفيديو الذي تم إنشاؤه أو لتطوير شخصية فريدة.
الخاتمة
يعد دمج AI-avatar أداة قوية لزيادة تفاعل المستخدمين، ولكنه يتطلب معالجة تقنية عميقة. من اختيار المنصة إلى الضبط الدقيق للخلفيات والتوقفات – تؤثر كل خطوة على النتيجة النهائية. لقد رأينا أن الشبكات العصبية قادرة على بث حياة جديدة في واجهات الصوت، ولكن فقط مع الاهتمام الدقيق بالتفاصيل.
إذا كنت ترغب في توسيع نطاق المحتوى الخاص بك وإنشاء فيديو AI للإعلانات، ففكر في إمكانيات الإنتاج العصبي بالاشتراك. يتيح لك ذلك إنشاء مئات المقاطع، سواء كانت AI UGC لمشروع عملات مشفرة أو مصنع مقاطع فيديو AI للتجارة الإلكترونية. نحن مستعدون لمساعدتك في ذلك! تواصل معنا لمعرفة كيف يمكن لإنتاج محتوى AI أن يحول عملك.